这篇你会看到
01歌有了,片子没有
02我以前是怎么配的
03第一步:先选段
04第二步:定镜头数
05第三步:保一致
06第四步:卡点
07第五步:回填
08画布式工具解决了哪一步
09我现在的做法
01歌有了,片子没有
我曲库里躺着几十首能听的歌,做成片子的不到十首。
不想做是一方面,更多是打开剪辑软件、看着一条空轨道,不知道从哪下手。歌是三分钟,素材是零,中间差的不是软件,是一张清单。
我本来以为难点是软件不会用,直到把片子拆成五步才发现,卡住我的是没有清单。后来问题就从「做个片子」变成「凑够十八个镜头」。后者是能干完的。
02我以前是怎么配的
最开始的错法:一句歌词配一个画面。
「你把围巾绕了两圈」配一条围巾,「楼下的灯亮了一半」配一盏灯。做出来像 PPT,每三秒换一张图,情绪全断了。
问题是:歌按段落走,不按句子走。一句词可能只占两秒,一个副歌段能顶十秒。按句配,等于把音乐的时间结构扔了。
03第一步:先选段
拿到一首歌,别急着想画面,先把时间轴切段。
我一般用工具先跑一遍结构分析,把段落和秒数拉出来。这是我那首六十秒小样的真实切分:
四段就是一篇文章的起承转合。先有这四个格子,再往里填画面,顺序反了就会乱。
04第二步:定镜头数
这一步最有效,也最省时间:先决定一共几个镜头,再决定每个镜头是什么。
我的经验值:60 秒的歌,15 到 20 个镜头;平均一个镜头 3 到 4 秒。慢歌拉到 4 到 5 秒,副歌段压到 2 到 3 秒。
按这个算,四段分下来大概是:
可复制模板
A 段 4 到 5 个(空镜为主)
B 段 5 到 6 个(人物进画)
C 段 6 到 7 个(切得最快)
D 段 3 到 4 个(收)
合计 18 到 22 个
有了数字,你就不会在副歌段落里放一个十秒长镜头——那是新手最容易犯的错,副歌一慢,整首歌都塌了。
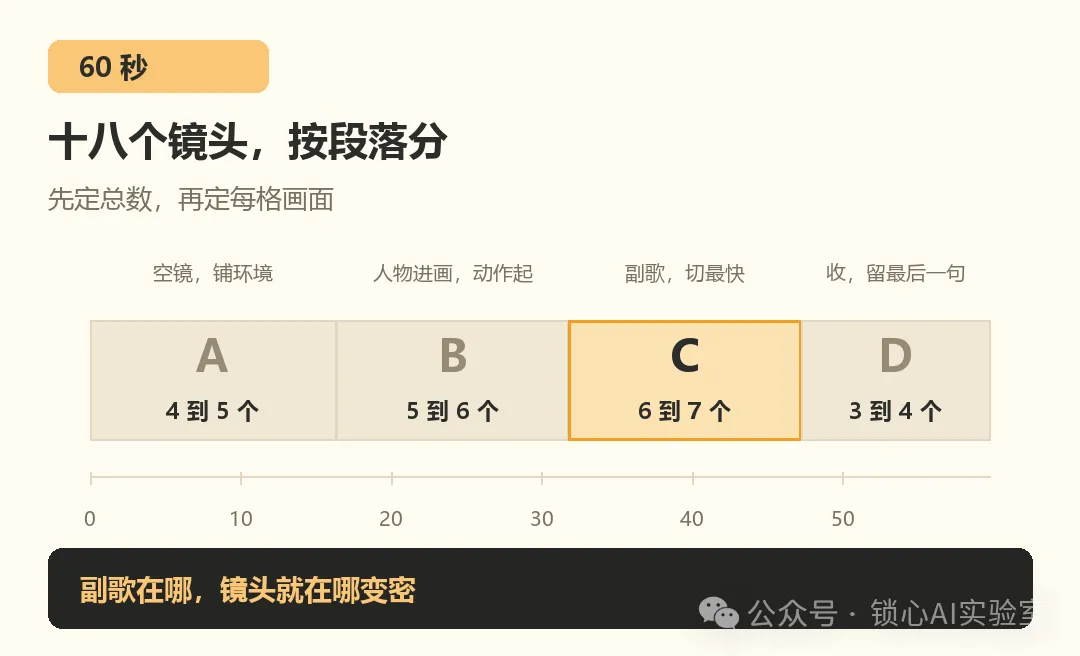
图注:四段的镜头数,副歌那段最密
05第三步:保一致
这一步是真正的门槛。同一件毛衣,第三个镜头变了个颜色;同一个人,第二个镜头换了张脸。观众立刻出戏。
我的土办法是:开拍前先定三样东西,之后所有镜头都围着这三样走。
· 人:发型、外套、一个固定的配饰
· 场景:一个主场景 + 一个副场景,别超过两个
· 光:冷还是暖,一个基调走到底
这也是最近这类画布型工具在解决的痛点。以 LiblibAI 出的 LibTV 为例,它把「角色三视图」和「主体库」做成了单独功能,同一个角色在不同镜头里能锁住;还有 9 宫格、25 宫格的多机位,等于先把一个空间的几个角度拍好,再挑。
对做 MV 的人来说,这比「模型多强」实在:一致性是能不能成片的分水岭,画质只是好不好看。
06第四步:卡点
卡点别每个鼓点都切一下,那样像电子相册。
我的做法是只卡四个位置:人声进、段落换、副歌起、最后一句落。四个位置卡准了,中间怎么切都顺。
拿上面那首举例:首字 1.017 秒,副歌 31.84 秒,收尾 47.3 秒。这三个数记下来,剪辑时直接对。
07第五步:回填
前面四步都是在纸上做,最后才打开软件。
顺序是:先把镜头表填满(每格写清画面、时长、景别),再生成素材,再按表往轨道上放。
这个顺序的好处是你能在没做出一个画面的情况下知道片子成不成立——十八个格子填不满,说明歌还没听透;填满了但每格都差不多,说明镜头没变化,得补远景或特写。
08画布式工具解决了哪一步
说回工具。这类画布型平台(LibTV 是一个代表)跟我以前用的「一个输入框一条视频」不是一回事。
它把剧本、分镜、镜头、剪辑摊在同一张画布上,每一块都能单独改、也能复制到下一段,这点跟我以前用惯的「一个输入框一条视频」完全是两种做法。你调整第三镜的灯光,不用重做前两镜。它还提供 Agent 接口,外部助手可以直接调它的生成能力。
这个改动的意义在第四步和第五步之间:以前镜头是散在各处的文件,现在是一张能看见全片的图。哪一段缺镜头,一眼就看出来。
不追求一次做完整首。先做 15 秒。
挑副歌前那 15 秒,拆 4 到 5 个镜头,做完看两件事:人有没有认出来,卡点有没有对。
这两件过了,再往前铺。过不了,说明这首歌不适合按现在这个思路配画面,换思路比硬做省时间。
写 在 最 后
来源与边界
· 五步拆法与镜头数区间,属于本人做片的经验值,行业里没有统一标准,慢歌快歌差别很大。
· 段落秒数(16.4 / 31.8 / 47.3 / 59.8)、首字 1.017 秒、副歌 31.84 秒,来自本账号成品的结构分析。
· LibTV 的画布式流程、双入口、角色三视图、主体库、多机位宫格,来自其官网与公开报道;本文作者未注册使用该产品,只做机制对照,不构成使用推荐。
· 各家公开资料对它所聚合的模型清单说法不一,本文故不列具体型号。
🎁 一起玩 · AI音乐视频交流群
做歌的、做视频的都在。会弹一点琴的,都可以进群聊一起讨论。
👆 长按识别二维码,直接进群
二维码 7 天有效 · 过期就看最新一篇里的码
进不了群,也可以后台私信我们
ABOUT
锁心AI实验室
一个用三年 AI 的爱好者,把怎么做出能听的歌、能看的 MV,公开地做给大家看。动手 · 看趋势 · 不藏私
在这里,你能看到
◆AI音乐 实测、歌词与咬字、工作流
◆AI视频 Mv方向实操、效果对比、踩坑实录
◆大模型与工具 趋势解读、Agent 玩法、自制小工具
每日更新 只发动手做过的、有用的。
你的歌做成片子了吗?卡在哪一步,评论区说说。
本文作者原创 · 转载请联系
本文配图为应用内截图 · 更新信息以官方日志为准